Quale computer comprare per l'intelligenza artificiale in locale: tutte le strade da 1.000 a 6.000 euro
Se compri da un nostro link, il negozio ci riconosce una piccola commissione. A te non costa nulla e non cambia l’ordine delle classifiche. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Come funziona.
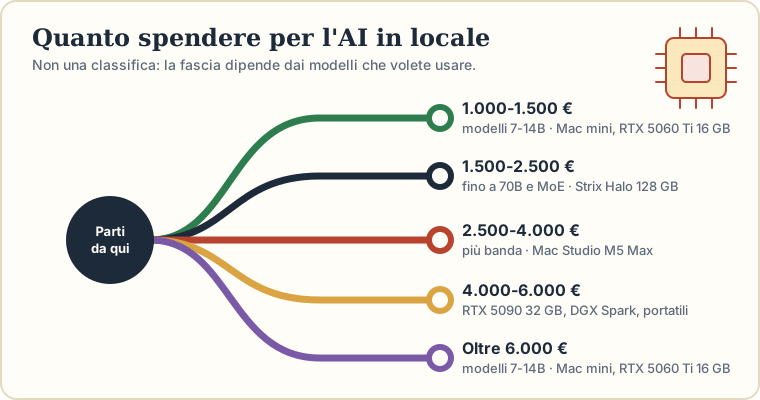
Non c'è un computer giusto per tutti: dipende da quale modello vuoi far girare. Sotto i 1.500 euro si comincia con modelli da 7-14 miliardi di parametri. Da 1.500 a 2.500 la memoria condivisa dei mini PC e dei Mac permette modelli molto più grandi, ma lenti se sono «densi»; le schede video sono velocissime ma fermano il modello a 16 o 32 GB. Oltre i 2.500 euro si compra soprattutto memoria: la velocità sui modelli davvero grandi resta la parte meno documentata.
Far girare un’intelligenza artificiale sul proprio computer, senza mandare i testi a un servizio online, è diventato possibile con macchine da 1.000 euro. Ma la scelta dell’hardware è meno ovvia di quanto sembri: la potenza del processore conta meno della memoria. Questa guida mette in fila le strade possibili, per fascia di prezzo, con le misure che abbiamo trovato e con i buchi che restano. Nessuna di queste macchine è passata dalle nostre mani: raccogliamo test, discussioni tecniche e schede dei produttori, e diciamo sempre da dove viene ogni numero.
Prima di tutto: cosa vuoi far girare
Un modello linguistico (in inglese LLM) è un programma che scrive testo. La sua «taglia» si misura in miliardi di parametri, indicati con la lettera B: 8B, 14B, 70B. Più è grande, di solito, più risponde bene, ma più memoria occupa. Per ridurre l’ingombro si usa la quantizzazione, una compressione che riduce i numeri del modello da 16 bit a 8 o a 4: la sigla Q4 vuol dire 4 bit, Q8 vuol dire 8. Il file pesa circa la metà a ogni passo.
Due sigle da conoscere. VRAM è la memoria della scheda video: quella veloce, ma limitata. MoE (mixture of experts, «miscela di esperti») indica i modelli in cui, per ogni parola, lavora solo una parte dei parametri: gpt-oss-120b ha 117 miliardi di parametri ma ne usa 5,1 miliardi alla volta. Un modello MoE va più veloce di un modello «denso» della stessa taglia, ma occupa comunque la memoria di tutto.
Ecco quanto pesano alcuni modelli, secondo i file pubblicati su Ollama, in gigabyte:
| Taglia | Esempio | Q4 | Q8 | Memoria realistica (stima nostra) |
|---|---|---|---|---|
| 7-8B denso | Llama 3.1 8B | 4,9 GB | non letto (Qwen3 8B: 8,9) | circa 6 GB |
| 14B denso | Qwen3 14B | 9,3 GB | 16 GB | circa 12 GB |
| 32B denso | Qwen3 32B | 20 GB | 35 GB | circa 25 GB |
| 70B denso | Llama 3.3 70B | 43 GB | 75 GB | circa 55 GB |
| MoE medio | gpt-oss-20b | 14 GB | – | circa 18 GB |
| MoE grande | gpt-oss-120b | 65 GB | – | circa 80 GB |
| MoE molto grande | Qwen3-235B-A22B | 142 GB | 250 GB | oltre 170 GB |
La colonna «memoria realistica» è una nostra stima: al file bisogna aggiungere il contesto e il sistema operativo, e abbiamo contato un 20-30 per cento in più, una regola pratica che non abbiamo verificato su una fonte. gpt-oss esiste solo a 4 bit, quindi non ha una colonna Q8. Il contesto, cioè il testo che il modello tiene presente, occupa memoria in più man mano che cresce: i documenti lunghi ne chiedono parecchia.
Non abbiamo trovato confronti indipendenti e seri tra i modelli locali e i servizi online: per questo non promettiamo che un modello locale valga ChatGPT o Claude. Un modello locale è una scelta per chi ci tiene alla privacy, ai costi fissi o alla curiosità.
Perché conta la memoria, e perché conta la banda
Il lavoro di un modello si divide in due fasi. Nella prima, il computer legge tutto il testo che gli hai dato (il «prefill»): è un lavoro di calcolo. Nella seconda scrive la risposta una parola alla volta, e ogni parola richiede di rileggere quasi tutti i parametri attivi. Qui il limite è la banda di memoria, cioè quanti gigabyte al secondo la memoria riesce a passare al chip, come spiega Redis. Un modello che pesa 20 GB richiede circa 20 GB letti per ogni parola.
La conseguenza si vede nella tabella della comunità llama.cpp, con Llama 7B a 4 bit (Q4_0): un MacBook con chip M5 Pro (307 GB/s dichiarati da Apple) genera circa 64 token al secondo, un M5 Max (614 GB/s) circa 103. Un token è un pezzetto di parola: 100 al secondo sono una risposta molto veloce, 5 una lettura faticosa. Nella stessa tabella la velocità di lettura del prompt dipende più dai core della GPU che dalla banda. È un modello piccolo e vecchio: serve a capire il meccanismo, non a prevedere le prestazioni con i modelli di oggi.
Da qui le tre strade:
- Memoria unificata (Mac, mini PC con chip Strix Halo, NVIDIA DGX Spark): processore e scheda grafica condividono un’unica grande memoria, fino a 128 GB o più. Ci stanno modelli enormi, ma la banda è più bassa di quella di una scheda video.
- Scheda video (VRAM): velocissima, ma con 16 o 32 GB. Se il modello ci sta, è la soluzione più veloce; se non ci sta, no.
- Ibrido: il modello sborda dalla scheda video nella RAM normale. Funziona, ma è lento: ComputingForGeeks parla di un calo di 5-10 volte, e una prova di Rost Glukhov su una RTX 4080 da 16 GB con un modello da 27 miliardi di parametri passa da 45 token al secondo, tutto in VRAM con una quantizzazione più spinta, a 20 quando sborda in RAM. Le eccezioni sono i MoE, che soffrono meno.
Per i chip Strix Halo, nella prova di un utente sul forum Framework la banda misurata è di circa 215 GB/s su 256 teorici: meno di un Mac M5 Max, molta più memoria di una scheda video.
Da 1.000 a 1.500 euro: si comincia, con dei limiti
Qui ci sono due famiglie. La prima sono i mini PC e i Mac di ingresso: l’Apple Mac mini M6 (16 GB di serie, 32 al massimo, listino attorno ai 1.079 euro secondo Melamorsicata), il Minisforum AI X1 Pro e il GMKtec EVO-X1, entrambi con Ryzen AI 9 HX 370. I produttori dichiarano modelli fino a 14-20B. Nessuna ha ancora misure indipendenti di velocità con i modelli di oggi.
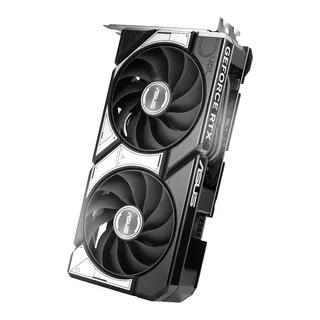
La seconda famiglia sono le schede video da inserire in un PC: l’ASUS Dual GeForce RTX 5060 Ti 16GB OC Edition e la Sapphire Pulse Radeon RX 9070 XT 16GB. Il loro prezzo (700-1.000 euro) è quello della sola scheda, e qui vale un avvertimento: se non hai già un PC recente serve tutto il resto. Un PC pronto con RTX 5080, 32 GB di RAM e 1 TB, sul sito Golookshop, costa 3.399 euro il 29/09/2026 contro i circa 1.550-1.800 della sola scheda: la differenza nostra, circa 1.600 euro, è il costo del «resto». Tra i componenti pesa la RAM: SysPack rileva che un kit da 32 GB di DDR5 è passato da 114 euro (settembre 2025) a 523 (agosto 2026), con una tensione dei prezzi che i produttori vedono durare oltre il 2027.
Cosa aspettarsi con 16 GB di VRAM: un 8B a 4 bit va a circa 59 token al secondo su una 5060 Ti e un 14B a circa 33 (LocalScore, un solo risultato, Q4_K_M). gpt-oss-20b, che dichiara di stare in 16 GB, fa 44 token al secondo sulla 5060 Ti con un contesto molto lungo (Hardware Corner, marzo 2026, contesto 128K) e 189 sulla 5070 Ti in una discussione llama.cpp, con un contesto corto. Un modello da 32 miliardi a 4 bit, 20 GB, non entra e finisce in RAM, con il calo di velocità visto sopra.
Da 1.500 a 2.500 euro: il cuore del mercato
È la fascia in cui si può comprare la capacità di far girare modelli grandi. Su questo punto contano tre categorie.
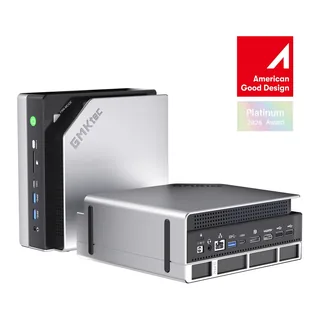
Mini PC Strix Halo. Il GMKtec EVO-X2 e il Framework Desktop hanno il chip Ryzen AI Max+ 395 con 128 GB di memoria unificata. Il Framework è la macchina con più misure pubbliche: Jeff Geerling ha registrato 33 token al secondo con gpt-oss-120b (che esiste solo a 4 bit) e 45 con gpt-oss-20b su una scheda madre con 128 GB; un utente del forum Framework segnala circa 72 token al secondo su Qwen3 30B-A3B con Vulkan, senza indicare la quantizzazione. Sui modelli «densi» il quadro è diverso: ServeTheHome ha misurato sul GMKtec EVO-X2 3,7-3,8 token al secondo con Llama 3.3 70B a Q6_K. Sono cifre di una macchina con la stessa memoria: la differenza sta nel MoE, che legge meno memoria per ogni parola. Il Qwen3-235B, con 142 GB a 4 bit, non entra in 128 GB.
Mac mini con chip M5 Pro. L’Apple Mac mini M5 Pro arriva a 64 GB di memoria e 307 GB/s dichiarati, e Apple ha software MLX maturo. La memoria massima è la metà di uno Strix Halo, e sul Mac mini non ci sono test indipendenti.
Schede video con più memoria. La MSI GeForce RTX 5070 Ti 16G Gaming Trio OC e l’ASUS Prime GeForce RTX 5080 16GB OC Edition hanno la stessa memoria delle schede sotto i 1.000 euro, con più velocità: chi vuole più memoria deve guardare la ASUS Turbo Radeon AI PRO R9700 32GB e la ASRock Intel Arc Pro B70 Creator 32GB, due schede per workstation con 32 GB a 1.550-1.800 euro. Entrano modelli da 27-35B a 4 bit, ma il software richiede più lavoro. Nella discussione llama.cpp n. 19890, la R9700 con Vulkan fa 127 token al secondo su un MoE da 35B a 4 bit contro 194 della 5090. Sulla Arc Pro B70, RunAIHome misura circa 22 token al secondo su un modello da 27B a 4 bit e circa 55 su un MoE da 35B con SYCL, il software ottimizzato di Intel; con Vulkan generico la stessa scheda va a circa il 45 per cento. Nessuna delle due è per chi cerca «installo e funziona».
Da 2.500 a 4.000 euro: qui si compra memoria
Sopra i 2.500 euro le alternative sono due. Il Minisforum MS-S1 Max ha lo stesso chip Strix Halo e 128 GB in un formato pensato per rack e cluster: comportamento simile all’EVO-X2 (bene i MoE, lenti i densi da 70B), senza test indipendenti a suo nome. L’Apple Mac Studio M5 Max 64 GB costa 3.709 euro da listino Apple e ha 614 GB/s di banda dichiarati, più del doppio di uno Strix Halo. Con 64 GB stanno i modelli da 30B e, stretto, un 70B a 4 bit (43 GB); non gpt-oss-120b, che pesa 65 GB. Il Mac Studio si può configurare fino a 128 GB con l’M5 Max, ma i prezzi delle configurazioni maggiorate non li abbiamo letti, e non li scriviamo.
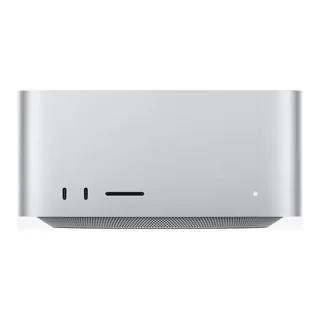
Il compromesso è chiaro: il Mac Studio ha più banda ma meno memoria di uno Strix Halo da 128 GB.
Sul Mac Studio M5 Max con modelli grandi non abbiamo trovato misure indipendenti: le cifre in giro sono di Apple o stime dalla banda, e le lasciamo fuori.
Da 4.000 a 6.000 euro (e appena oltre): il tetto
In questa fascia le scelte sono cinque, e ognuna ha un difetto.
L’Apple MacBook Pro 16 pollici M5 Max 48 GB è il portatile con più banda (614 GB/s), a 5.799 euro di listino; con 48 GB non ci entra il 70B. Costa più di un Mac Studio con più memoria: si paga la portabilità. L’ASUS ROG Strix SCAR 18 G835LX è un portatile da gioco con la RTX 5090 Laptop, che ha 24 GB e non 32, e 896 GB/s contro 1.792: nello scoreboard llama.cpp fa 156 token al secondo su Llama 2 7B Q4_0 contro circa 300 della 5090 desktop. Costa 4.199 euro sull’eShop ASUS Italia (listino 5.099).
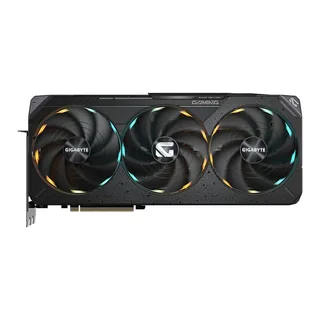
La Gigabyte GeForce RTX 5090 Gaming OC 32G è la scheda più veloce che si compra: nei test di Hardware Corner, con llama.cpp, Q4_K_XL e contesto da 4K, fa 186 token al secondo su Qwen3 8B, 124 su 14B e 61 su 32B. Ma il 70B a 4 bit non entra nei 32 GB, e va in RAM. Costa da 5.290 a 6.500 euro la sola scheda, e in un negozio abbiamo visto un’altra Gigabyte a oltre 9.900 euro: prezzi troppo diversi per fissarne uno. Per il resto del PC, un pronto con RTX 5090 (Golookshop) parte da 7.499 euro, cioè tra 1.000 e 2.200 euro più della scheda. Il listino di lancio NVIDIA era 1.999 dollari.
La NVIDIA DGX Spark Founders Edition ha 128 GB di memoria e CUDA completo, ma genera circa 3 token al secondo su Llama 3.3 70B in FP8, secondo utenti del forum NVIDIA: è una macchina per sviluppatori. L’Apple Mac Studio M5 Ultra 96 GB, a 6.699 euro, ha 1,2 TB/s dichiarati, la banda più alta di tutte, ma parte da 96 GB: per i modelli più grandi servono configurazioni superiori molto più care, e la 512 GB arriva solo a fine ottobre.
Restano fuori dalle schede la NVIDIA RTX PRO 6000 Blackwell, con 96 GB di GDDR7 (nella versione Server Edition costa 28.338 euro su PcComponentes) e i PC preassemblati, fuori scala o senza recensioni indipendenti. In sintesi: la 5090 va molto più veloce, ma solo sui modelli che entrano in 32 GB; le macchine a memoria unificata fanno girare modelli più grandi, a una velocità che dipende dal tipo di modello.
Il software per cominciare
Non serve saper programmare:
- Ollama: si installa e si lancia un modello con un comando. Supporta NVIDIA (CUDA), Radeon (ROCm v7), Apple (Metal) e Vulkan su Windows e Linux. Sulla Arc Pro B70 la versione ufficiale gira sul processore.
- LM Studio: applicazione con interfaccia grafica, per Mac con chip Apple, Windows e Linux; su Mac servono macOS 14 e sono consigliati 16 GB.
- llama.cpp: il motore che sta dietro a molti programmi, con supporto a Metal, CUDA, HIP, Vulkan e SYCL.
- MLX: il software di Apple, pensato per la memoria unificata dei Mac. vLLM è invece pensato per server con più utenti.
Consumi e rumore
I dati misurati esistono solo per Strix Halo. Sul GMKtec EVO-X2, ServeTheHome misura 8-14 W a riposo e 147-160 W con Llama 3.3 70B a Q6_K, con 41-43 dBA di rumore; Geerling parla di circa 11 W a riposo e 150 W a pieno carico sulla scheda madre Framework. Per i Mac abbiamo solo dati di targa Apple, in test di carico massimo (non in inferenza): l’M5 Max 7 W a riposo e 200 W al massimo, l’M5 Ultra 9 W e 385 W. Per la RTX 5090 il dato di targa è 575 W per la sola scheda, con alimentatore da 1.000 W consigliato; il consumo del PC intero in inferenza non l’abbiamo trovato misurato.
Un conto di riferimento, con il prezzo ARERA di 31,63 centesimi al kWh (clienti vulnerabili in maggior tutela; sul mercato libero cambia): un mini PC Strix Halo a 150 W per due ore al giorno consuma circa 110 kWh l’anno, cioè circa 35 euro. Lasciato acceso 24 ore con 10 W a riposo, circa 60 euro. Un PC con RTX 5090 da 700 W di sistema, ipotesi nostra non misurata, per due ore al giorno con 30 W a riposo: circa 510 kWh, 160 euro.
Privacy: cosa cambia davvero
Il vantaggio è semplice: con un modello locale il testo che scrivi non parte verso il server di un fornitore. Non c’è un terzo a cui trasmettere il dato. Il resto non cambia: se tratti dati personali di altri, restano la base giuridica, l’informativa e la sicurezza del computer. Nel parere del 18/12/2024 l’EDPB, l’organismo europeo dei garanti, dice che la valutazione dei modelli di AI si fa caso per caso e non affronta la differenza tra locale e cloud. Nemmeno il Garante italiano lo dichiara conforme in automatico. Non abbiamo trovato una fonte istituzionale che dica «per dati sanitari usa solo il locale».
Errori da evitare
- Comprare per i TOPS. Il numero di operazioni al secondo dell’NPU non misura la velocità con cui scrive un modello: contano memoria e banda.
- Confondere 128 GB di memoria con 128 GB di VRAM. Su alcune macchine la quota assegnabile alla GPU ha un tetto: HP dichiara fino a 96 GB su 128.
- Fidarsi dei numeri stimati. Molti siti «proiettano» i token al secondo dalla banda. Noi riportiamo solo misure con configurazione dichiarata, e diciamo quando sono di un chip precedente.
- Dimenticare la RAM. Nel 2026 pesa molto sul preventivo del PC.
Vedi anche la nostra guida ai mini PC per l’intelligenza artificiale in locale, il confronto tra GMKtec EVO-X2 e Framework Desktop, quello tra Apple Mac mini M6 e GEEKOM IT15 e come scegliere un mini PC. Per capire cosa c’è dentro questi modelli, i libri per capire l’intelligenza artificiale.
Cosa manca
- Misure indipendenti sui Mac Studio con M5 Max e M5 Ultra con modelli grandi, e sul Mac mini M6 e M5 Pro.
- Misure di un modello da 70B con una sola RTX 5090: le cifre che circolano sono di siti secondari.
- Il consumo in inferenza dei Mac, del PC con RTX 5090 e del rumore di schede da 300-575 W.
- Le schede RTX 50 da 24 GB: sono voci non confermate, senza data. Chi compra oggi una 5070 Ti o una 5080 compra 16 GB.
- I prezzi: cambiano ogni giorno, e li abbiamo letti il 29/09/2026 in negozi diversi. Le fasce sono indicative.
I titoli, uno per uno
Da 1.000 a 1.500 euro
Apple Mac mini M6
- Processore: Apple M6, CPU 12-core
- Grafica: GPU 12-core integrata nel chip M6, con Neural Accelerator in ogni core GPU (novità M6)
- RAM: 16 GB di memoria unificata (configurabile fino a 32 GB), banda di memoria 170 GB/s
- SSD: da 256 GB a 1 TB a seconda della configurazione
- Porte video: 3x Thunderbolt 4 sul retro
Il punto d'ingresso Apple: chip M6, 16 GB di memoria unificata (configurabile fino a 32 GB) e 170 GB/s di banda dichiarati. Con 16 GB restano i modelli da 7-8 miliardi di parametri; con 32 GB si arriva ai 14B e a gpt-oss-20b, che pesa 14 GB. È silenzioso ed efficiente, ma il tetto è basso: oltre 32 GB non si va. Il chip è uscito il 22/09/2026, quindi non ci sono ancora misure indipendenti di velocità né un voto.
- Efficienza energetica molto elevata rispetto ai mini PC Windows a parità di prestazioni dichiarate
- Garanzia legale di conformità 24 mesi, rete Apple Store consolidata in Italia
- Apple dichiara fino a 4 volte le prestazioni IA rispetto al Mac mini M4 (dato del comunicato, non un benchmark indipendente)
- Tetto di memoria unificata di 32 GB: fuori portata gli usi più esigenti
- Non esegue nativamente software Windows: da valutare per chi cerca un PC generico
Per chi è: Chi è già nell'ecosistema Apple o cerca un mini PC molto efficiente e silenzioso per usi creativi/ufficio, senza necessità di software Windows.
Minisforum AI X1 Pro
- Processore: AMD Ryzen AI 9 HX 370, 12 core/24 thread, fino a 5,1 GHz
- Grafica: AMD Radeon 890M (RDNA 3.5)
- RAM: DDR5 SO-DIMM, non saldata, configurazioni da 32 GB a 64 GB (fino a 128 GB su alcune varianti)
- SSD: PCIe 4.0 M.2, 512 GB-1 TB nelle configurazioni vendute; barebone disponibile senza SSD
- Porte video: doppio USB4, non rilevato in dettaglio oltre questo
Mini PC Windows con Ryzen AI 9 HX 370, memoria SO-DIMM non saldata (32-64 GB, alcune varianti fino a 128 GB) e porta OCuLink per una scheda video esterna. È la scelta flessibile: si può cambiare la RAM e, in futuro, aggiungere una GPU. La banda di memoria è però quella di un PC normale, molto sotto un Mac o uno Strix Halo, e non abbiamo trovato misure indipendenti. Amazon.it 4,3/5 su 24 valutazioni.
- Prezzo di ingresso più basso della famiglia Ryzen AI 9 HX 370 sui rivenditori italiani
- RAM SO-DIMM espandibile, non saldata: raro tra i mini PC con questa CPU
- Doppia 2,5G LAN e Oculink per eventuale eGPU
- Nessun benchmark LLM indipendente trovato nelle fonti aperte: le prestazioni AI reali non sono verificate
- Banda di memoria dell'HX 370 più stretta di Strix Halo: modelli oltre i 14-20B saranno lenti
Per chi è: Chi vuole provare l'AI locale con modelli piccoli/medi (fino a circa 14-20B) o giocare a 1080p con margine di espansione futura, accettando l'assenza di benchmark indipendenti certificati.
GMKtec EVO-X1
- Processore: AMD Ryzen AI 9 HX 370 (12C/24T Zen 5, fino a 5,1 GHz)
- Grafica: AMD Radeon 890M (16 CU, RDNA 3.5)
- RAM: 32 GB LPDDR5X-7500 saldata, non espandibile
- SSD: doppio slot PCIe 4.0 NVMe, fino a 8 TB
- Porte video: USB4, HDMI 2.1, DisplayPort 2.1
Stesso processore del Minisforum, il Ryzen AI 9 HX 370, ma con 32 GB di LPDDR5X-7500 saldati e non espandibili, più OCuLink e doppio slot per SSD. 32 GB bastano per un 14B a 4 bit e per gpt-oss-20b; sui 27-32B si va stretti. Su Amazon.it ha 4,5/5 su 393 valutazioni, condivise con altri modelli del marchio, e la garanzia è di un anno.
- Porta OCuLink indipendente per aggiungere una GPU dedicata vera
- Doppio slot NVMe fino a 8 TB
- NPU XDNA2 fino a 50 TOPS, LPDDR5X-7500 più veloce della DDR5 generica
- Con sola grafica integrata basta per gaming AAA solo a dettagli moderati
- RAM saldata, non espandibile
Per chi è: Chi vuole un mini PC con CPU potente e la possibilità di aggiungere in futuro un'eGPU via OCuLink, sia per giocare a dettagli medi sia per modelli AI fino a 14-20B.
ASUS Dual GeForce RTX 5060 Ti 16GB OC Edition
- GPU: NVIDIA GeForce RTX 5060 Ti (Blackwell, 4.608 core CUDA)
- VRAM: 16 GB GDDR7, bus a 128 bit
- Banda di memoria: 448 GB/s
- Consumo: 180 W (TGP dichiarato da NVIDIA)
- Alimentatore consigliato: 550 W (ASUS su PcComponentes), 600 W (NVIDIA); 1 connettore da 8 pin
Il modo più economico per avere una scheda NVIDIA con 16 GB di VRAM. Un modello da 8 miliardi di parametri a 4 bit genera circa 59 token al secondo e un 14B circa 33 (LocalScore, un solo risultato, Q4_K_M); un 32B a 4 bit, 20 GB, non entra. Il prezzo è quello della sola scheda: serve un PC con alimentatore da 550-600 W. Amazon.it 4,6/5 su 504 valutazioni.
- 16 GB di VRAM a un prezzo molto più basso di 5070 Ti e 5080
- Consumo contenuto: basta un alimentatore da 550-600 W e un connettore da 8 pin
- Nei test citati fa 59 tok/s su Llama 3.1 8B e 33 tok/s su Qwen2.5 14B in Q4_K_M (LocalScore, un solo risultato)
- Banda di soli 448 GB/s: un 14B a 4 bit genera 26-33 tok/s, un 32B non entra
- Quando il modello non entra in 16 GB e va in RAM, la velocità scende di 5-10 volte (ComputingForGeeks)
Per chi è: Per chi vuole provare l'AI in locale con modelli fino a 14B (e gpt-oss-20b) spendendo il meno possibile; non per chi vuole un 32B o contesti molto lunghi.
Lo trovi anche su: Sito ufficiale
Sapphire Pulse Radeon RX 9070 XT 16GB
- GPU: AMD Radeon RX 9070 XT (RDNA 4, 4.096 stream processor)
- VRAM: 16 GB GDDR6 a 20 Gbps, bus a 256 bit
- Banda di memoria: 640 GB/s
- Consumo: 304 W (dato PcComponentes)
- Alimentatore consigliato: 750 W; 2 connettori da 8 pin
Scheda AMD da 16 GB con 640 GB/s: in llama.cpp con Vulkan decodifica un modello piccolo (Llama 2 7B Q4_0) a 137 token al secondo, contro circa 100 con ROCm, il software AMD per l'AI. Funziona con Ollama e LM Studio su Windows. Ha gli stessi 16 GB delle NVIDIA e quindi gli stessi limiti, ma il software è meno collaudato. Alimentatore da 750 W. Amazon.it 4,6/5 su 788 valutazioni.
- Banda di 640 GB/s: in llama.cpp con Vulkan decodifica Llama 2 7B Q4_0 a 137 tok/s
- Funziona con Ollama e LM Studio su Windows tramite Vulkan, senza driver ROCm
- Voto dei clienti su PcComponentes: 4,6/5 su 601 recensioni
- 16 GB: gli stessi limiti di 5060 Ti e 5070 Ti sui modelli sopra i 14-20 miliardi di parametri
- Con ROCm decodifica più piano che con Vulkan sui modelli piccoli (101 contro 137 tok/s sullo stesso test)
Per chi è: Per chi vuole 16 GB a meno di una 5070 Ti, gioca anche e accetta di usare Vulkan o ROCm invece di CUDA.
Lo trovi anche su: Sito ufficiale
Da 1.500 a 2.500 euro
GMKtec EVO-X2
- Processore: AMD Ryzen AI Max+ 395, 16 core/32 thread Zen 5, fino a 5,1 GHz, TDP 120 W stabile (picco 140 W)
- Grafica: AMD Radeon 8060S, RDNA 3.5, 40 compute unit
- RAM: 64 GB o 128 GB LPDDR5X-8000 saldata, bus 256 bit
- SSD: doppio M.2 2280 PCIe 4.0 x4, fino a 8 TB totali dichiarati
- Porte video: DisplayPort 1.4, HDMI 2.1
Il mini PC di riferimento con chip Strix Halo (Ryzen AI Max+ 395) e 64 o 128 GB di memoria unificata. ServeTheHome ha misurato 3,7-3,8 token al secondo su Llama 3.3 70B a Q6_K, troppo pochi per una chat; in quella prova il consumo in inferenza era di 147-160 W, con 41-43 dBA. Con i modelli MoE la storia cambia, come mostra il Framework. Amazon.it 4,3/5 su 1.683 valutazioni, condivise con il marchio.
- Uno dei pochi Strix Halo testati con numeri pubblicati da una fonte indipendente rispettata (ServeTheHome)
- 128 GB permettono di caricare modelli MoE molto grandi, anche se lentamente
- Disponibile tramite rivenditori europei con consegna in Italia
- Prezzi molto variabili tra rivenditori per la stessa configurazione: occorre confrontare prima di comprare
- Llama 3.3 70B a Q6_K gira a soli 3,7-3,8 tok/s secondo ServeTheHome: usabile solo per compiti non interattivi, non per una chat fluida
Per chi è: Chi vuole il punto di riferimento della categoria per caricare modelli AI molto grandi in locale, o una grafica integrata di fascia alta per giocare, accettando tempi di risposta lenti sui modelli dense oltre i 30B.
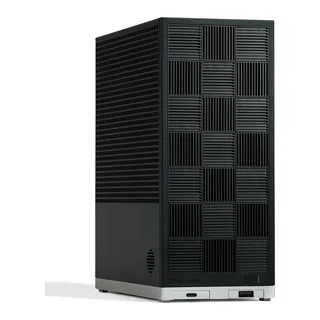
Framework Desktop
- Processore: AMD Ryzen AI Max 385 (8C/16T) o Ryzen AI Max+ 395 (16C/32T Zen 5), a seconda della configurazione
- Grafica: AMD Radeon RDNA 3.5 integrata (Radeon 8060S nella versione Max+ 395, memoria indirizzabile fino a 96 GB)
- RAM: LPDDR5X-8000 unificata saldata: 32 GB nella versione Max 385, 128 GB nella versione Max+ 395
- SSD: slot interno M.2 + scheda di espansione storage USB 3.2 Gen2 opzionale (250 GB/1 TB)
- Porte video: non rilevato nel dettaglio dalle fonti consultate
Stesso chip Strix Halo in un case Mini-ITX riparabile, in versione da 32 GB o da 128 GB. È la macchina con più misure pubbliche: Jeff Geerling ha rilevato 33 token al secondo con gpt-oss-120b e 45 con gpt-oss-20b su una scheda madre Framework con 128 GB. La memoria è saldata: la capacità si sceglie all'acquisto. Il prezzo cambia con la configurazione (da 1.400 a 2.400 euro circa).
- Case Mini-ITX standard: componenti sostituibili/riparabili, non un blocco chiuso
- RAM unificata scalabile fino a 128 GB, condivisibile tra CPU e GPU
- Benchmark pubblici più dettagliati della categoria (Jeff Geerling): GPT-OSS 120B a 33 tok/s in generazione sulla versione 128 GB
- Prezzo in euro per l'Italia non confermato sul sito ufficiale
- RAM saldata: la capacità va scelta all'acquisto, non modificabile dopo
Per chi è: Chi vuole un mini PC riparabile e componibile, sia per gaming con grafica integrata di fascia alta sia per l'AI in locale, scegliendo la configurazione di RAM in base al budget.
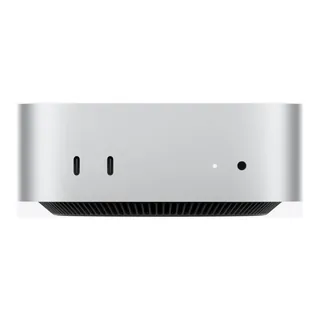
Apple Mac mini M5 Pro
- Processore: Apple M5 Pro, CPU 15-core o 18-core secondo configurazione
- Grafica: GPU integrata Apple M5 Pro, 16 o 20 core secondo configurazione
- RAM: 24 GB o 64 GB unificata
- SSD: da 512 GB a 1 TB nelle configurazioni base
- Porte video: Thunderbolt 5
Mac mini di fascia alta: fino a 64 GB di memoria unificata e 307 GB/s dichiarati da Apple, con un listino da circa 2.029 euro. Con 64 GB entrano i modelli densi fino a circa 30B e un 70B a 4 bit (43 GB) ci sta con poco margine, per stima nostra. L'unica misura letta sul chip M5 Pro è su un MacBook Pro da 24 GB: 64 token al secondo su Llama 7B Q4_0. Per il Mac mini non ci sono ancora test indipendenti.
- 307 GB/s di banda dichiarati da Apple, la cifra più alta tra i Mac mini attuali e comparabile ai migliori Strix Halo
- Fino a 64 GB di memoria unificata, sufficienti per modelli dense fino a circa 30B quantizzati
- Thunderbolt 5 ed ecosistema MLX maturo per Apple Silicon
- Prezzo di ingresso già alto (2.029 € circa) e sale rapidamente con la configurazione a 64 GB
- Nessun benchmark LLM indipendente trovato al 29/09/2026; SSD saldato, non sostituibile
Per chi è: Chi vuole il massimo di RAM e banda che Apple offre oggi per l'AI locale, con priorità a efficienza e silenziosità piuttosto che a capacità estrema; senza voto perché non ci sono ancora abbastanza valutazioni degli acquirenti.
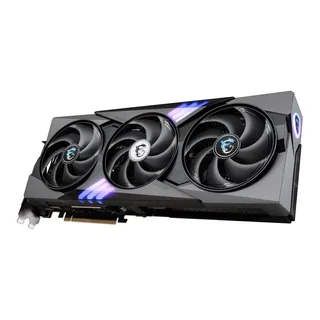
MSI GeForce RTX 5070 Ti 16G Gaming Trio OC
- GPU: NVIDIA GeForce RTX 5070 Ti (Blackwell, 8.960 core CUDA)
- VRAM: 16 GB GDDR7 a 28 Gbps, bus a 256 bit
- Banda di memoria: 896 GB/s (calcolata da bus e velocità)
- Consumo: 300 W (TGP NVIDIA)
- Alimentatore consigliato: 750 W con connettore a 16 pin (NVIDIA e PcComponentes)
Ha lo stesso limite di 16 GB della 5060 Ti, ma 896 GB/s di banda, calcolati da bus e velocità della memoria: nello scoreboard llama.cpp fa 182 token al secondo su Llama 2 7B Q4_0 e arriva a 189 con gpt-oss-20b. Serve a chi vuole risposte rapide sui modelli fino a 14B. Costa 1.349 euro su PcComponentes (29/09/2026), alimentatore da 750 W, scheda lunga 338 mm. Amazon.it 4,6/5 su 287 valutazioni.
- Nello scoreboard llama.cpp fa 182 tok/s su Llama 2 7B Q4_0, pari a una 5080
- Con gpt-oss-20b arriva a 189 tok/s
- Voto dei clienti su PcComponentes: 4,7/5 su 484 recensioni
- Sempre 16 GB: un 32B a 4 bit non ci sta
- Costa 1.349 € su PcComponentes il 29/09/2026, quasi il doppio di una 5060 Ti
Per chi è: Per chi vuole la massima velocità sui modelli fino a 14B e su gpt-oss-20b e non pretende modelli più grandi.
Lo trovi anche su: Sito ufficiale
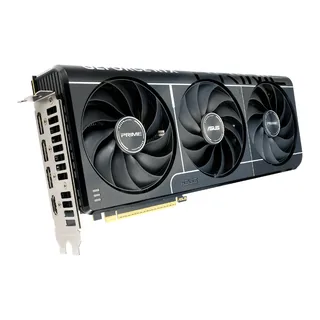
ASUS Prime GeForce RTX 5080 16GB OC Edition
- GPU: NVIDIA GeForce RTX 5080 (Blackwell, 10.752 core CUDA)
- VRAM: 16 GB GDDR7, bus a 256 bit
- Banda di memoria: 960 GB/s
- Consumo: 360 W (TGP NVIDIA)
- Alimentatore consigliato: 850 W con connettore a 16 pin
Con 960 GB/s è più veloce della 5070 Ti, ma la memoria è sempre di 16 GB: 185 token al secondo su Llama 2 7B Q4_0 e 205 su gpt-oss-20b nelle discussioni llama.cpp, contro 182 e 189 della sorella minore. Si spendono quasi 1.800 euro per un guadagno che si vede solo sui modelli che già entrano. Ha senso se giochi molto; per l'AI conviene guardare i 32 GB. Alimentatore da 850 W. Amazon.it 4,6/5 su 171 valutazioni.
- 185 tok/s su Llama 2 7B Q4_0 e 205 tok/s su gpt-oss-20b nelle discussioni llama.cpp
- Formato compatto per una 5080 (ASUS la dichiara adatta ai case piccoli)
- Voto dei clienti su PcComponentes: 4,8/5 su 672 recensioni
- 16 GB di VRAM per circa 1.800 €: sui 32B si va in RAM e la velocità cala
- Costa più del doppio di una 5060 Ti e la sua velocità in più si vede solo sui modelli che già entrano
Per chi è: Per chi gioca e usa l'AI e vuole il massimo con modelli fino a 14B o gpt-oss-20b; per l'AI sui modelli grandi conviene una scheda da 32 GB.
Lo trovi anche su: Sito ufficiale
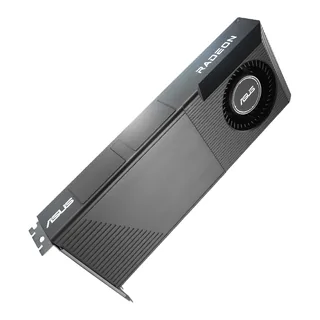
ASUS Turbo Radeon AI PRO R9700 32GB
- GPU: AMD Radeon AI PRO R9700 (RDNA 4, 4.096 stream processor, 128 acceleratori AI)
- VRAM: 32 GB GDDR6, bus a 256 bit
- Banda di memoria: 640 GB/s
- Consumo: 300 W (TBP)
- Alimentatore consigliato: 750 W minimo; connettore 12V-2x6
Scheda AMD per workstation con 32 GB di GDDR6, in due slot con ventola blower: entrano modelli da 27-35B a 4 bit. Nella discussione llama.cpp n. 19890 un MoE da 35B fa 127 token al secondo con Vulkan contro 194 della 5090, e la lettura del prompt è 2,6 volte più lenta. Richiede più pazienza col software (Vulkan o ROCm). Amazon.it 4,0/5 su sole 25 valutazioni: pochi dati.
- 32 GB di VRAM: entrano modelli 27-35B a 4 bit
- 127 tok/s su Qwen3.5-35B-A3B in Vulkan, contro 194 tok/s della 5090
- Formato a due slot con blower adatto alle workstation, anche a due schede
- Elaborazione del prompt 2,6 volte più lenta della 5090 sullo stesso modello (discussione llama.cpp)
- Sui modelli densi da 27B genera 23-33 tok/s per la banda di 640 GB/s
Per chi è: Per chi vuole i 32 GB spendendo molto meno di una 5090 e usa soprattutto modelli MoE con Linux o Vulkan.
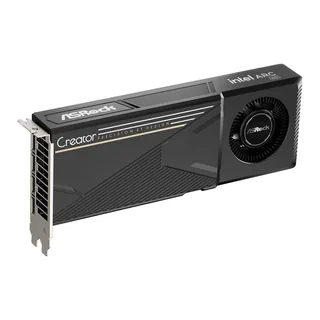
ASRock Intel Arc Pro B70 Creator 32GB
- GPU: Intel Arc Pro B70 (Xe2, 32 core Xe, 256 motori XMX)
- VRAM: 32 GB GDDR6, bus a 256 bit
- Banda di memoria: 608 GB/s
- Consumo: 160-290 W secondo Intel; 225 W dichiarati dalla pagina PcComponentes per questo modello
- Alimentatore consigliato: non dichiarato da Intel; una pagina Sparkle indica 750 W
Scheda Intel per workstation con 32 GB e 608 GB/s: la VRAM più economica tra le schede nuove. Il rovescio è il software: la strada veloce (SYCL) chiede di compilare llama.cpp a mano e l'Ollama ufficiale gira sul processore. Con software ottimizzato si leggono circa 22 token al secondo su un 27B a 4 bit e circa 55 su un MoE da 35B (RunAIHome). Amazon.it 5,0/5 su 13 valutazioni: non è un dato solido. Per esperti, meglio con Linux.
- 32 GB di VRAM a circa 1.700 € (PcComponentes, 29/09/2026)
- Consumo dichiarato più basso di 5090 e R9700
- Pensata per il multi-GPU su Linux con oneAPI
- Su Amazon.it 5,0/5 ma su sole 13 valutazioni: un voto che non dice ancora molto
- Software: la strada veloce (SYCL) richiede di compilare llama.cpp a mano; Vulkan generica va a circa il 45 % (RunAIHome)
Per chi è: Per chi vuole molta VRAM spendendo poco e sa usare Linux e compilare software; non per chi cerca «installo e funziona».
Da 2.500 a 4.000 euro
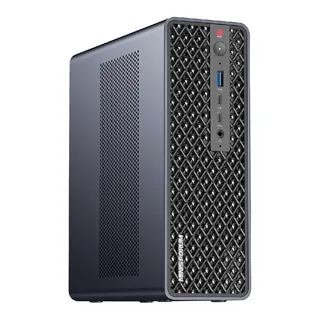
Minisforum MS-S1 Max
- Processore: AMD Ryzen AI Max+ 395, 16 core/32 thread
- Grafica: AMD Radeon integrata, descritta dal produttore come equivalente a RTX 4070 Laptop più accelerazione NPU
- RAM: 128 GB LPDDR5X-8000 quad-channel
- SSD: non rilevato nel dettaglio dalle fonti consultate
- Porte video: non rilevato nel dettaglio dalle fonti consultate
Strix Halo con 128 GB di memoria unificata, in un mini PC pensato anche per il rack e per i cluster, con USB4v2 a 80 Gbps. Ha gli stessi chip e la stessa banda dell'EVO-X2: bene sui modelli MoE fino a gpt-oss-120b, lento sui densi da 70B. Non abbiamo trovato test indipendenti di questo modello, e il picco dichiarato arriva a 160 W. Amazon.it 4,8/5 su 13 valutazioni: pochissime.
- Supporto rack 2U pensato per chi vuole affiancare più unità in cluster
- 128 GB quad-channel, tra le dotazioni di RAM più ampie della categoria
- USB4v2 a 80 Gbps, la dotazione più veloce tra i mini PC Strix Halo verificati
- Nessun benchmark LLM indipendente reperito in questa ricerca: le cifre disponibili sono dichiarazioni del produttore
- Prezzo in euro non confermato da un rivenditore ufficiale italiano
Per chi è: Chi valuta un piccolo cluster di mini PC Strix Halo o cerca la connettività USB4 più veloce disponibile in questa fascia, per l'AI locale su modelli molto grandi.
Apple Mac Studio M5 Max 64 GB
- Chip: Apple M5 Max, CPU 18 core, GPU 40 core
- Memoria unificata: 64 GB (configurabile fino a 128 GB)
- Banda di memoria: 614 GB/s (dichiarata da Apple)
- SSD: 1 TB (configurabile fino a 8 TB)
- Formato: Desktop 9,5 x 19,7 x 19,7 cm, 2,7 kg
Il Mac desktop di ingresso serio: M5 Max con GPU a 40 core, 64 GB e 614 GB/s dichiarati, listino Apple 3.709 euro. Su Llama 7B Q4_0 la tabella llama.cpp dà circa 103 token al secondo, contro 64 dell'M5 Pro: la generazione cresce con la banda. Con 64 GB stanno i 30B e, stretto, un 70B a 4 bit; non gpt-oss-120b, che pesa 65 GB. Silenzioso; nessun test indipendente su modelli grandi.
- 614 GB/s di banda: più del doppio di un Mac mini M5 Pro (307 GB/s) e generazione dei token molto più rapida a parità di modello
- Silenzioso e di piccole dimensioni rispetto a un PC con scheda video separata
- Software maturo per l'AI locale: MLX, LM Studio, Ollama e llama.cpp funzionano su Apple Silicon
- 64 GB non bastano per i grandi modelli MoE (gpt-oss-120b, Qwen3-235B): servono 128 GB o più
- Il prompt processing su contesti lunghi resta il punto debole dei Mac, secondo le prove lette per le generazioni precedenti
Per chi è: Chi vuole un computer silenzioso per usare LLM fino a circa 30-70B in locale e non ha bisogno dei modelli più grandi; senza voto, chip appena uscito (consegne dal 22/09/2026).
Da 4.000 a 6.000 euro (e appena oltre)
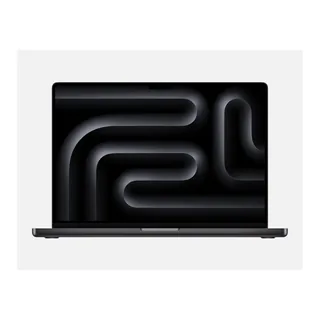
Apple MacBook Pro 16 pollici M5 Max 48 GB
- Chip: Apple M5 Max, CPU 18 core, GPU 40 core
- Memoria unificata: 48 GB (configurabile fino a 128 GB, prezzo non letto)
- Banda di memoria: 614 GB/s (dichiarata da Apple per la GPU a 40 core)
- SSD: 2 TB
- Formato: Portatile 16 pollici
Il portatile con più banda della selezione: M5 Max a 40 core GPU, 48 GB e 614 GB/s dichiarati, listino Apple 5.799 euro. Con 48 GB entrano i modelli fino a circa 30B a 4 bit, non il 70B. Costa molto più del Mac Studio (3.709 euro con 64 GB): si paga la portabilità. Ha senso se serve un solo computer per lavoro e AI, non per una scrivania fissa. Nessuna prova indipendente su questa configurazione.
- Stessa banda dichiarata del Mac Studio M5 Max con GPU a 40 core, in un portatile
- Portabilità e batteria: uso in mobilità
- Software MLX, llama.cpp e LM Studio maturo su Apple Silicon
- Costa molto più di un Mac Studio con la stessa memoria: 48 GB a 5.799 € contro 64 GB a 3.709 € del Mac Studio
- In un portatile la potenza sostenuta sotto carico prolungato può essere inferiore: non misurato nelle fonti lette
Per chi è: Chi vuole un solo computer portatile che faccia anche AI locale con modelli fino a circa 30B quantizzati; senza voto, chip appena uscito.
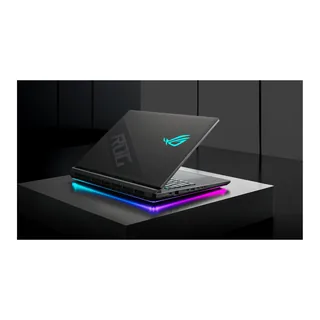
ASUS ROG Strix SCAR 18 G835LX (RTX 5090 Laptop 24GB)
- GPU: NVIDIA GeForce RTX 5090 Laptop (Blackwell)
- VRAM: 24 GB GDDR7, bus a 256 bit
- Banda di memoria: 896 GB/s (StorageReview)
- Consumo: TGP massimo 175 W sul modello 2026 (ROG); sistema fino a 320 W
- Alimentatore consigliato: alimentatore fornito con il portatile
Portatile da gioco con RTX 5090 Laptop, che ha 24 GB di VRAM e non i 32 della scheda desktop, con banda di 896 GB/s contro 1.792. Nello scoreboard llama.cpp fa 156 token al secondo su Llama 2 7B Q4_0, contro circa 300 della 5090 da tavolo. Prezzo ASUS eShop Italia il 29/09/2026: 4.199 euro (listino 5.099). Pesa 3,3 kg; in batteria la velocità cala molto secondo StorageReview, su un altro modello.
- 24 GB di VRAM in un portatile
- RAM espandibile fino a 64 GB (modello 2025) con slot SO-DIMM
- ASUS eShop Italia il 29/09/2026: 4.199 € contro 5.099 € di listino, garanzia 3 anni
- Velocità circa metà della 5090 desktop: 156 contro 300 tok/s su Llama 2 7B Q4_0 (scoreboard llama.cpp)
- In batteria le prestazioni scendono del 40-60 % (StorageReview su un altro portatile)
Per chi è: Per chi ha bisogno di un solo computer portatile per l'AI e il lavoro e accetta velocità e peso; un desktop a parità di prezzo va più veloce.
Gigabyte GeForce RTX 5090 Gaming OC 32G
- GPU: NVIDIA GeForce RTX 5090 (Blackwell, 21.760 core CUDA)
- VRAM: 32 GB GDDR7, bus a 512 bit
- Banda di memoria: 1.792 GB/s
- Consumo: 575 W (TGP NVIDIA)
- Alimentatore consigliato: 1.000 W con connettore a 16 pin (NVIDIA, Gigabyte, PcComponentes)
32 GB di GDDR7 e 1.792 GB/s: nei test di Hardware Corner (llama.cpp, Q4_K_XL, contesto 4K) fa 186 token al secondo su Qwen3 8B, 124 su 14B e 61 su 32B. Il 70B a 4 bit, 43 GB, non entra. Su Amazon.it ha 4,0/5 su 80 valutazioni e il prezzo varia molto da un negozio all'altro (da 5.290 a 6.500 euro), ben oltre il listino di lancio di 1.999 dollari. Il prezzo è della sola scheda.
- In llama.cpp: 300 tok/s su Llama 2 7B Q4_0, 124 tok/s su Qwen3 14B e 61 tok/s su Qwen3 32B in Q4_K_XL
- Con Qwen3.5-35B-A3B fa 194 tok/s, 1,5 volte una R9700
- Voto dei clienti su PcComponentes: 4,7/5 su 92 recensioni
- Su Amazon.it il voto è 4,0/5 su 80 valutazioni, sotto quello delle altre schede video della selezione
- Consumo di 575 W e alimentatore da 1.000 W: si somma alla spesa del resto del PC
Per chi è: Per chi ha un budget vicino ai 6.000 € solo per la scheda e vuole eseguire modelli da 27-35B senza compromessi; per la maggior parte degli utenti basta molto meno.
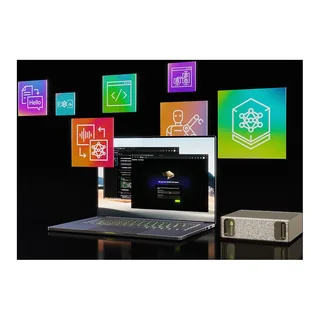
NVIDIA DGX Spark Founders Edition
- Processore: NVIDIA GB10 Grace Blackwell superchip
- Grafica: GPU Blackwell integrata nel superchip GB10
- RAM: 128 GB unificata
- SSD: 4 TB NVMe (configurazione Founders Edition venduta in Italia)
- Porte video: non rilevato nel dettaglio dalle fonti consultate
Mini computer NVIDIA con 128 GB di memoria unificata e software CUDA completo, pensato per chi sviluppa. Sui modelli densi grandi la generazione è lenta: utenti del forum NVIDIA riportano circa 3 token al secondo su Llama 3.3 70B in FP8, perché a frenare è la banda di memoria. Costa 5.500-8.000 euro. Non è la scelta per una chat veloce, ma per chi ha bisogno di CUDA e di molta memoria. Amazon.it 4,3/5 su 96 valutazioni.
- Stack software CUDA completo, il più maturo per lo sviluppo AI tra le piattaforme di questa selezione
- 128 GB di memoria unificata permettono di caricare modelli fino a 200 miliardi di parametri dichiarati dal produttore
- Rete ad altissima velocità per collegare più unità in cluster, con partner OEM (ASUS, Dell, Gigabyte, HP, Lenovo, MSI)
- Prezzo nettamente il più alto di questa selezione, fuori portata per un uso amatoriale
- Su Llama 3.1/3.3 70B a singolo utente la generazione è di soli 2,7-3 tok/s circa: più lenta di un GMKtec EVO-X2 sullo stesso ordine di grandezza di modello, secondo le fonti consultate
Per chi è: Sviluppatori professionali che hanno bisogno dello stack CUDA per prototipare e vogliono la massima compatibilità software, non chi cerca la chat più veloce possibile con un modello da 70B.
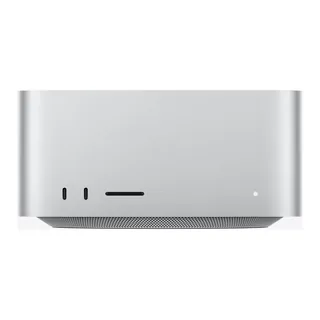
Apple Mac Studio M5 Ultra 96 GB
- Chip: Apple M5 Ultra, CPU 30 core, GPU 64 core
- Memoria unificata: 96 GB (configurabili 256 GB e 512 GB, questi ultimi da fine ottobre)
- Banda di memoria: 1,2 TB/s (dichiarata da Apple)
- SSD: 1 TB (configurabile fino a 16 TB)
- Formato: Desktop 9,5 x 19,7 x 19,7 cm, 3,6 kg
M5 Ultra con 96 GB e 1,2 TB/s dichiarati, listino Apple 6.699 euro: è il tetto del nostro percorso. Ha la banda più alta, ma la memoria di partenza è di 96 GB, meno dei 128 GB che si possono mettere su un M5 Max; per i modelli più grandi servono configurazioni superiori, molto più care (512 GB solo da fine ottobre). Non abbiamo trovato misure indipendenti su modelli grandi: le cifre in giro sono di Apple o di prove non verificate.
- 1,2 TB/s: la banda più alta tra i computer di questa selezione
- Silenzioso anche sotto carico (spider-mac)
- Cluster di più Mac Studio via Thunderbolt 5: Apple dichiara fino a 3 volte con 4 macchine (dato del produttore)
- Appena sopra i 6.000 €: è il tetto della nostra selezione
- La base da 96 GB ha meno memoria massima di un M5 Max configurato a 128 GB (spider-mac)
Per chi è: Chi ha un budget oltre i 6.000 € e vuole velocità massima su modelli fino a 96 GB; per i modelli giganti serve la versione con più memoria. Senza voto, chip appena uscito.
Domande frequenti
Quanta RAM serve per un modello da 8 miliardi di parametri?
Il file di Llama 3.1 8B pesa 4,9 GB nel formato predefinito di Ollama; Qwen3 8B 5,2 GB a 4 bit e 8,9 GB a 8 bit. A questo si aggiunge la memoria per il contesto (il testo che il modello tiene presente) e per il sistema: con 16 GB di memoria si sta comodi.
Perché serve più memoria e non solo un processore più potente?
Perché il modello deve stare intero in memoria. gpt-oss-120b pesa 65 GB, più dei 32 GB di una RTX 5090: la scheda è velocissima, ma il modello non ci entra.
Cos'è la banda di memoria e perché conta?
È la quantità di dati che la memoria riesce a passare al chip ogni secondo. Per generare ogni parola il computer rilegge quasi tutto il modello, quindi la velocità di scrittura dipende soprattutto dalla banda. Nella tabella llama.cpp, a parità di modello, il chip con più banda genera più token al secondo.
Perché con un documento lungo la prima risposta arriva lenta?
Perché prima il computer deve leggere tutto il testo, e quella fase (prefill) dipende dalla potenza di calcolo, non dalla banda. Nelle tabelle llama.cpp la velocità di lettura segue il numero di core della GPU più che la banda.
Serve per forza una scheda video NVIDIA?
No. Ollama supporta anche le Radeon AMD con ROCm, i Mac con Metal e, su Windows e Linux, Vulkan. llama.cpp copre CUDA, Metal, HIP e Vulkan. NVIDIA resta il percorso più collaudato, ma non l'unico.
Meglio la quantizzazione a 4 bit o a 8 bit?
L'8 bit occupa quasi il doppio (Qwen3 14B: 9,3 GB contro 16 GB). Una perdita di qualità passando a 4 bit esiste, ma nelle fonti lette non c'è una misura da riportare: si valuta caso per caso.
Quanto costa in energia far girare un modello in locale?
Con 31,63 centesimi al kWh (riferimento ARERA per i clienti vulnerabili in maggior tutela, non il mercato libero), un mini PC Strix Halo a 150 W per due ore al giorno costa circa 35 euro l'anno. Un PC con RTX 5090 da 700 W di sistema, che è una nostra ipotesi non misurata, costerebbe circa 160 euro.
Si può usare un modello locale in azienda con dati riservati?
Il testo non lascia il computer, ma gli obblighi del GDPR restano: base giuridica, informativa, sicurezza. L'EDPB e il Garante non dichiarano il locale conforme in automatico: la valutazione è caso per caso.
Le fonti
Recensioni degli acquirenti e test pubblicati, letti alla data di aggiornamento indicata in cima. Nessuna di queste fonti ha rapporti con noi.
- Ollama, gpt-oss (dimensioni dei file 20b e 120b, formato MXFP4) - letta il 29/09/2026
- Ollama, Qwen3 (tag e dimensioni dei file quantizzati) - letta il 29/09/2026
- Ollama, Llama 3.3 (tag e dimensioni dei file quantizzati) - letta il 29/09/2026
- llama.cpp, discussione «Performance of llama.cpp on Apple Silicon» (misure su Llama 7B) - tabella della comunità, non un test di una redazione
- Redis, Prefill vs decode: perché la generazione è limitata dalla banda - 28/04/2026; blog di un produttore, spiegazione tecnica
- Comunità Framework, prove di Ryzen AI Max+ 395 con llama.cpp - banda misurata circa 215 GB/s; prove di utenti
- Jeff Geerling, prove su schede madri Framework con Strix Halo - gpt-oss-120b e 20b, consumo a riposo e a pieno carico
- ServeTheHome, recensione GMKtec EVO-X2 (consumi e rumore) - misure con Llama 3.3 70B Q6_K
- Apple, consumo di energia e dissipazione termica dei Mac Studio - dati di targa a riposo e a carico massimo, non in inferenza
- ARERA, prezzo di riferimento dell'energia elettrica, terzo trimestre 2026 - 31,63 centesimi al kWh per i clienti vulnerabili in maggior tutela, non il prezzo di mercato libero
- Hardware Corner, benchmark RTX 5090 con llama.cpp - 06/11/2025; Q4_K_XL, contesto 4K
- llama.cpp, discussione RTX 5090 contro R9700 (25/02/2026) - misure di utenti su un modello MoE da 35B
- SysPack, Mercato RAM e SSD 2026 - prezzi della RAM DDR5 a settembre 2025 e ad agosto 2026
- EDPB, parere sui modelli di AI e sul GDPR (18/12/2024) - non tratta l'esecuzione locale in quanto tale
- LocalScore, risultati per la GeForce RTX 5060 Ti 16 GB - benchmark raccolti dagli utenti con llama.cpp
- Hardware Corner, benchmark LLM della RTX 5060 Ti 16 GB - token al secondo per taglia di modello
- llama.cpp, guida all'esecuzione di gpt-oss (discussione 15396) - configurazioni e misure su GPU e CPU
- RunAIHome, Radeon AI PRO R9700 e Arc Pro B70 per l'AI locale - guida con misure; per la B70 vedi anche la pagina dedicata dello stesso sito
Immagini: Apple, Minisforum, GMKtec, ASUS, Sapphire, Framework, Newegg, ASUS ROG, NVIDIA (materiale stampa dei produttori o dei negozi partner, uso editoriale). Tutti i crediti.